Raspberry Pi · Великобритания
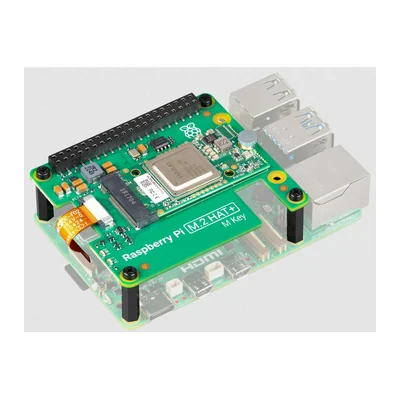
Raspberry Pi AI HAT+ 26 TOPS
Справочник
Модель становится вчетверо меньше и в два-четыре раза быстрее. Вопрос в том, на сколько процентов она при этом глупеет.
Модель, обученная в FP32, хранит каждый вес в четырёх байтах. Перевод в INT8 сокращает объём вчетверо: меньше памяти, меньше обменов с ней, выше скорость.
Ускорители бортовых вычислителей считают целочисленные операции кратно быстрее, чем с плавающей точкой, а паспортные TOPS почти всегда указывают для INT8, иногда для INT4. Скорость в таблице — для ускорителя с аппаратной поддержкой INT8; на процессоре без неё выигрыш меньше.
Выигрыш по энергии не менее важен: меньше обращений к памяти означает меньше ватт, а на борту это прямо переходит во время полёта.
| Точность | Размер модели | Относительная скорость | Типовая потеря качества |
|---|---|---|---|
| FP32 | ×1 | ×1 | нет |
| FP16 | ×0,5 | ×2 | практически нет |
| INT8 с калибровкой | ×0,25 | ×3–4 | 0,5–2 % |
| INT8 без калибровки | ×0,25 | ×3–4 | до 10 % и больше |
| INT4 | ×0,125 | ×5–8 | заметная, требует переобучения |
Квантование отображает диапазон вещественных значений в 256 уровней. Если диапазон выбран неверно, часть значений обрезается, а часть уровней тратится впустую.
Калибровка — это прогон через модель нескольких сотен характерных кадров, по которым определяется фактический диапазон активаций в каждом слое.
Кадры для калибровки должны быть из той же съёмки, что и рабочие: модель, откалиброванная на дневных кадрах, на сумеречных потеряет заметно больше.
Послетренировочное квантование берёт готовую модель и калибрует её. Быстро, не требует обучающего набора и в большинстве случаев даёт приемлемый результат.
Обучение с учётом квантования моделирует ошибку округления прямо в процессе обучения. Дороже по времени и требует полного набора данных, зато потеря качества минимальна.
Практический порядок: сначала послетренировочное квантование; если потеря велика, переходить к обучению с учётом квантования.
Не среднюю точность, а поведение на сложных случаях: мелкие объекты, низкий контраст, край кадра. Квантование бьёт именно по ним.
Скорость измеряют на целевом устройстве под нагрузкой, а не на настольной машине: при троттлинге выигрыш от квантования частично съедается.
Отдельно смотрят, какие слои ушли на процессор вместо ускорителя: один неквантуемый слой в середине сети может свести весь выигрыш к нулю.
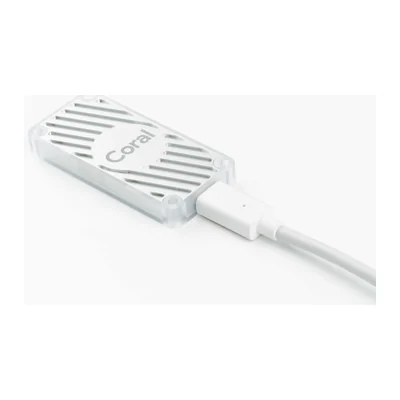
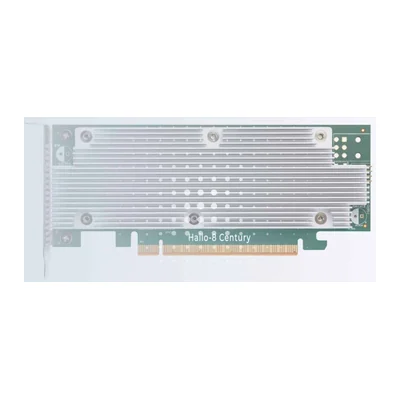
Число TOPS имеет смысл только вместе с точностью. В нашем каталоге Hailo-10H заявлен как 40 TOPS — это INT4, в INT8 у того же чипа 20 TOPS. У Hailo-8 26 TOPS, у Google Coral Edge TPU 4 TOPS — оба для INT8.
Модель в FP16 или FP32 на таких ускорителях либо не запускается, либо уходит на процессор. Edge TPU выполняет только полностью целочисленные модели TensorFlow Lite, а всё, что идёт после первой неподдерживаемой операции, компилятор отдаёт процессору.
Порядок проверки поэтому обратный привычному: сначала узнать, какую точность и какие операции поддерживает ускоритель, потом выбирать архитектуру сети.
| Ускоритель из каталога | Заявлено | Точность |
|---|---|---|
| Hailo-10H | 40 TOPS / 20 TOPS | INT4 / INT8 |
| Hailo-8 | 26 TOPS | INT8 |
| Hailo-8L | 13 TOPS | INT8 |
| Google Coral Edge TPU | 4 TOPS | INT8 |
| Allwinner MR527 | 2 TOPS | INT8 |
| Allwinner V851s | 0,5 TOPS | INT8 |
Первое средство — квантовать веса по каналам, а не одним масштабом на весь слой. У разных фильтров разный разброс значений, и общий масштаб съедает мелкие.
Второе — смешанная точность: часть слоёв оставляют в FP16. Обычно это первый свёрточный слой и выходная часть детектора, где считаются координаты рамок; остальная сеть остаётся в INT8.
Цена — скорость. Каждый переход между INT8 и FP16 требует пересчёта, а на ускорителе без FP16 такие слои уходят на процессор. Поэтому смешанную точность проверяют замером на целевом устройстве, а не по отчёту компилятора.
Позиции каталога, к которым относится всё сказанное выше.